


概要
メタデータ株式会社は、数千人規模がAIと対話した大量の質問ログ、アンケート自由記述、社内技術メモ、問い合わせ履歴などを対象に、自動で分類・整理し、その結果をChatBridのRAG(検索拡張生成)の改善に直結させる『RAGクラスタリング』技術をこのたび開発しました。
本技術は、単に文を似たもの同士にまとめるだけではありません。分類カテゴリ自体を自動生成し、さらにその分類名や説明を人間可読に整えるためにLLMを補助的に利用することで、従来のクラスタリング結果にありがちだった『人間には意味が読み取りにくい』という弱点を大きく改善します。
また、木構造分類を一気に出力するため、利用者は見たい粒度を選んで閲覧でき、後から何度も再分類し直すことなく、分析結果をすぐにFAQ整備、質問ログ分析、自由記述分析、RAG高度化などへ活用できます。本『RAGクラスタリング』技術は、大規模対応高精度RAG(検索拡張生成)製品のChatBridのオプションとして組み込んでRAG搭載知識の改善に寄与させ、2026年11月以降に出荷いたします。
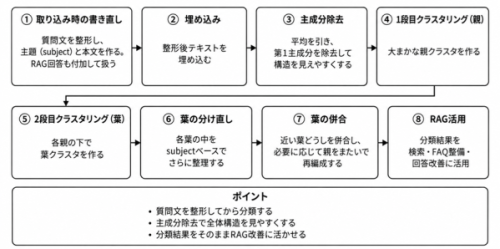
【画像 https://www.dreamnews.jp/press/366685/images/bodyimage1】
図1 RAGクラスタリング全体パイプライン(記者様向け簡略版)
開発の背景
生成AIの業務活用が進む中で、企業や組織には、チャットログ、問い合わせ履歴、会議メモ、障害メモ、日報、アンケート自由記述など、大量の非定型テキストが急速に蓄積されています。
しかし従来は、こうしたデータを活かすために、あらかじめ人間が分類カテゴリを設計するか、クラスタリング結果を人間が目で読み解いて再整理する必要がありました。そのため、データ量が増えるほど、分類・整理の負担が大きくなり、結果の活用スピードが落ちるという課題がありました。
とりわけRAGを高度化するうえでは、単に検索対象を増やすだけでなく、『どのような質問が多いのか』『どの論点が混線しているのか』『どの単位でFAQ化・知識化すべきか』を把握することが重要です。この課題に対し、メタデータ株式会社は、分類そのものを知識整備プロセスに組み込み、RAG改善へ循環利用できる実用的な仕組みとしてRAGクラスタリング技術を開発しました。
本技術の主な特長
1. 分類カテゴリ自体を自動生成できること (Jevには不可)
2. 分類名・説明文を人間に分かりやすく整えるためにLLMを補助的に活用していること
3. 従来のクラスタリング結果が人間に理解しにくいという問題を改善していること
4. 木構造分類を一気に出力することで、クラスタ粒度を選んで活用できること
5. 分類結果をRAG、FAQ整備、ログ分析、自由記述分析へそのまま接続できること
6. 外部ネットワークに接続しない、完全ローカルな環境でも動作すること
1. 分類カテゴリそのものを自動生成
本方式は、質問ログや自由記述を処理しながら、分類先となるカテゴリ群そのものを生成します。これにより、人手で分類枠を先に定義しきれない新規領域や変化の早い業務領域でも、実データから論点構造を立ち上げることが可能になります。
2. LLMは『分類名を人間可読にする』ために補助的に利用
本方式におけるLLMの役割は、主として質問文の正規化などの精度を上げる部分と、クラスタの見出し付け、説明文生成など、人間が理解しやすい形に整える部分です。つまりLLMを全面的なブラックボックス分類器として使うのではなく、埋め込み・クラスタリングの補助と、結果を『読むための知識構造』へ翻訳する補助として利用している点に特徴があります。そのため質問文の前処理さえしていれば、クラスタリング自体の処理時間は短く済みます(※見出し付け、説明文生成の処理は時間がかかるので工夫が必要です)。
3. 従来クラスタリングの『読みにくさ』を改善
従来のクラスタリングでは、近い文どうしがまとまっても、その塊が『何の話か』を人間が直ちに理解しにくいことが多くありました。本方式では、クラスタ名、説明、階層構造、代表質問の提示を通じて、分類結果がそのまま会議資料・改善検討・社内共有に使える形に整えられます。
4. 木構造分類を一気に生成
本方式では、分類結果を木構造として一気に生成するため、木構造のどこまでを表示するかを変更することで、粗い分類から細かい分類まで調節できます。利用者は『全体傾向を見たい』『中分類単位で見たい』『もっと細かい分類を見たい』など、目的に応じた粒度を最初から選択できるため、再分類や分類設計のやり直しを最小化できます。
5. 分類結果をそのまま利用
本方式のもう一つの大きな特長は、クラスタリング結果を「分析レポート」で終わらせず、そのまま次の業務処理へつなげられる点です。
たとえば、AIとの対話ログや問い合わせ履歴を分類すると、「どの質問が多いか」「似た質問がどのような表現で繰り返されているか」「どの論点で回答が不足しているか」といった傾向を、階層構造と件数の両方から把握できます。そこで見つかった頻出クラスタは、そのままFAQ候補や新たな知識整備対象として利用できます。ユーザからgood/badのフィードバックを得ている場合、badボタンが多く押されたクラスタは資料が不十分だったりするのではないか?などと提案することも可能となります。
ChatBridのRAGと組み合わせる場合は、クラスタリングによって見つかった論点をもとに、検索対象文書の追加・整理、質問表現の拡充、検索条件やリランキングの見直し、理想回答の整備などへフィードバックできます。つまり、実際の利用ログから「RAGが次に何を改善すべきか」を自動的に発見する仕組みとして利用できます。
また、アンケート自由記述や社内技術メモのように、必ずしも質問形式ではないデータにも応用できます。大量の文章を似た論点ごとに整理し、人間が理解しやすい分類名や見出しを付けることで、従来は担当者が目視で読み込んでいた自由記述分析やナレッジ整理を大幅に効率化できます。
このように、本技術は「分類するためのクラスタリング」ではなく、分類結果をFAQ整備、知識構築、検索改善、RAG評価・改善へ循環させるための技術として設計されています。利用データが蓄積するほど、組織内で何が問われ、どの知識が不足し、どこを改善すべきかが見えるようになり、RAGを継続的に育てる基盤として活用できます。
6. ローカル環境でも動作可能
本方式で使用するモデルはEmbedding ModelとLLMのみであり、いずれもローカル環境での動作を確認しています。Embedding Modelは軽量で、LLMについてもパラメータ数が12B程度の比較的小規模なモデルで十分な精度が得られることを確認しています。このため、計算資源が限られる環境でも導入・運用しやすく、外部サービスにデータを送信することなく、ローカル環境内で処理を完結できます。
※当社の検証結果に基づくものであり、必要な計算資源や精度は、利用環境や対象データによって異なります。
【画像 https://www.dreamnews.jp/press/366685/images/bodyimage2】
図2 出力イメージ:粒度を切り替えることができる木構造分類
JevなどのDecision Modelとの違い
既存の分類支援系アプローチの一つであるJev(※当社検証に基づく整理)などのDecision Modelでは、あらかじめ与えた分類カテゴリに対して、個々の文書や質問文を振り分ける用途には適している一方、分類カテゴリ自体をデータから自動生成する用途には向いていないと考えられます。また、埋め込みと比べると処理に時間がかかり、多くの計算資源を必要とするため、より速さが求められる用途や、計算資源が限られる環境には適していないと考えられます。
これに対し、本方式は、前処理した実データの分布から高速にカテゴリ構造そのものを立ち上げ、さらにそのカテゴリ名を人間可読に整えることで、『未知の論点が混ざる大規模データ』でも、分析・整理の入口から出口までを一気通貫で支援できます。
この違いは、大規模アンケート自由記述や、技術メモ・運用記録・質問ログのように、事前に完全な分類体系を設計しにくいデータで特に大きな意味を持ちます。
技術上・実務上の意義
本技術の重要な意義の一つは、『大規模な未整理テキスト群を、業務でそのまま使える知識構造へ自動変換できること』にあります。これは単なる分析の自動化ではなく、知識基盤を継続的に育てるための常用的な基盤技術であり、RAGと結びつくことで、検索精度・回答品質・FAQ整備・問い合わせ削減・ナレッジ共有を同時に押し上げる可能性があります。
主な応用用途
● アンケート自由記述分析:顧客や従業員の声を、論点・悩み・要望ごとに自動整理
● 社内技術メモ整理:議事録、障害メモ、設計メモ、検証メモを再利用しやすい知識構造へ変換
● 質問ログ分析:AIや社内ヘルプデスクへの質問ログを分類し、FAQ候補や改善論点を抽出
● RAG高度化:分類結果を知識整備、検索改善、リランキング、回答改善へ循環利用
● 大規模会話ログ整理:数千人規模の対話ログから頻出論点や潜在需要を抽出
【画像 https://www.dreamnews.jp/press/366685/images/bodyimage3】
図3 主な応用領域(4象限マップ)
想定される産業応用
本技術は、製造、建設、防衛、自治体、医療、教育、BPO、コールセンター、社内ITサポートなど、大量の問い合わせ・記録・対話ログ・自由記述を扱う多様な業種に展開可能です。
たとえば、アンケート自由記述の傾向把握、社内技術メモの整理、FAQ候補の抽出、組織横断の問い合わせ傾向分析、RAG導入後の改善サイクル設計などに応用できます。
特にChatBridと一体化して利用することで、『データが増えるほど、分類とRAGがともに賢くなる』という循環が成立し、従来の“RAGを作って終わり”ではない、継続改善型の産業応用が開けます。
RAGとの一体運用
本技術は、分類・整理のためだけの独立ツールではなく、RAGの知識整備・運用改善サイクルの中核部品として設計されています。すなわち、現場データを分類し、結果を人間が理解しやすい知識構造へ整え、それを検索・回答改善へ戻し、その利用結果からさらに新たなデータから知識を抽出・整理し、蓄積されるという循環を実現します。
【画像 https://www.dreamnews.jp/press/366685/images/bodyimage4】
図4 データ生成からRAG改善までの循環
今後の展開
メタデータ株式会社は今後、本技術をChatBridの知識整備・評価・改善サイクルの中にさらに組み込み、大規模会話ログ、自由記述、技術文書、問い合わせ履歴などの知識化を進めます。
また、分類結果の説明性向上、階層構造の見せ方の改善、リランキングやFAQ自動整備との連携、オンプレミス環境での運用強化などを進め、幅広い業種での実装を加速していく予定です。
☆★☆★☆★☆
メタデータ株式会社について
メタデータ株式会社は、企業・組織の知識を生成AIで安全かつ実務的に活用するための基盤技術を提供しています。主力製品である「ChatBrid」は、RAG、権限制御、知識整備、評価・改善サイクルを統合したエンタープライズ向け生成AI活用基盤です。
配信元企業:メタデータ株式会社
プレスリリース詳細へ
ドリームニューストップへ
