

- 自社の基幹データや顧客情報を、外部の生成AIサービスに接続してよいのか
- どこまでのデータを、誰がアクセスできる形でつなげばよいのか
こうした判断基準を持てないまま、生成AIの業務活用を足踏みさせている経営者や情報システム担当者もいるのではないでしょうか。
その判断のヒントになる出来事が、2026年9月1日、最もデータの外部持ち出しに慎重だったはずの医療分野で起きました。OpenAIが電子カルテ大手Epicの環境をChatGPTに接続できるようにし、Microsoftも同じ日に「モデルより先にデータ基盤」と発表したのです。
本記事では、この接続がどのような設計のもとで行われたのかを整理し、自社の基幹データを外部AIにつなぐ際に何を先に固めるべきかを解説します。
【本記事の要点】
- 2026年9月1日、OpenAIは医療機関がEpicの電子カルテ環境をChatGPT for Healthcareに接続できるようにしたと発表した。読み取り専用で、カルテへの書き戻しはできない
- 接続は役割ベースのアクセス制御・監査ログ・事業者間の取り決め(BAA)を備え、3億2,500万件規模の患者記録を対象にしている
- 同じ日、Microsoftは「医療AIの成否はモデル選びより前に、統合され統治されたデータ基盤で決まる」と発表し、医療機関の97%がデータの分断を課題に感じているという調査結果を示した
- 最も慎重だった医療分野が接続設計をともなって動き出したことは、AI導入の判断が「どのモデルを選ぶか」ではなく「どのデータを、どこまで、どういう権限でつなぐか」に移っていることを示している
医療データが、外部の汎用AIとつながり始めた
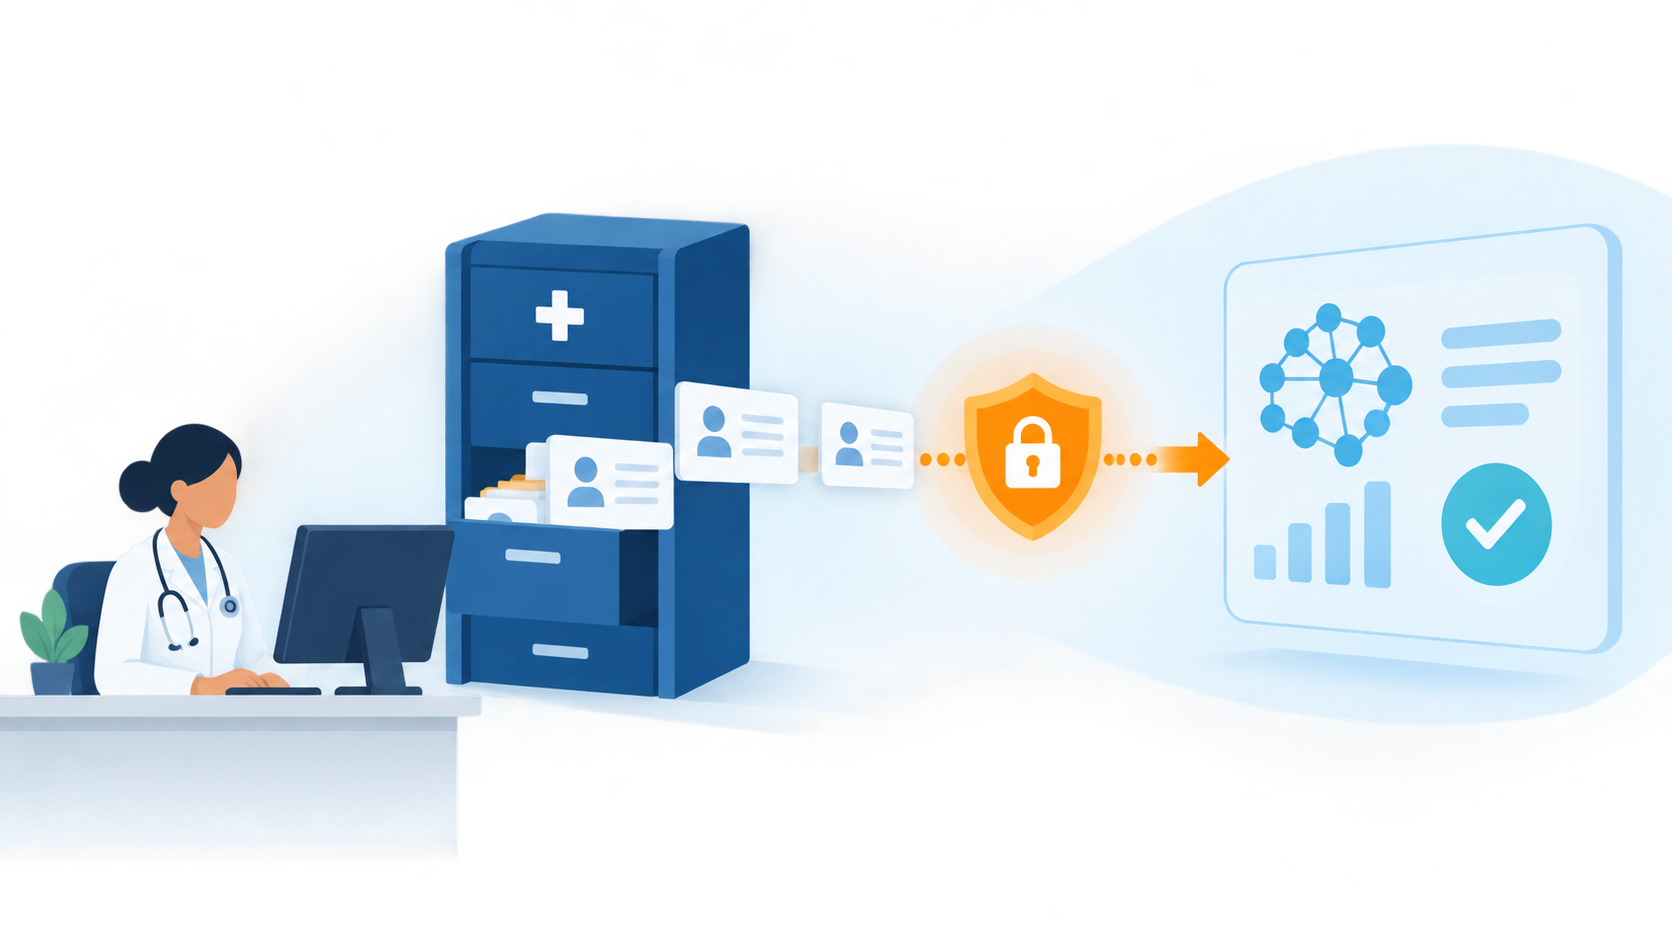
2026年9月1日、OpenAIは医療機関が電子カルテ(EHR)大手Epicの環境をChatGPT for Healthcareに接続できるようにしたと発表しました。この接続により、ChatGPTが患者情報を参照できるようになり、認可された臨床医は予約前の準備や前回受診からの変化の確認といった場面で、その情報を呼び出して使えるようになります。あわせて、PubMedやCMSの公的医療データなど9つの情報源に構造的にアクセスできるプラグインも提供されました。
医療データは、個人情報保護と業界規制のいずれの観点からも、外部サービスへの持ち出しに最も慎重であるべき情報の1つです。その医療データが、汎用の生成AIサービスと公式に接続され始めたという事実そのものが、この発表の重みを物語っています。
「読み取り専用」「認可」「監査ログ」という接続の設計
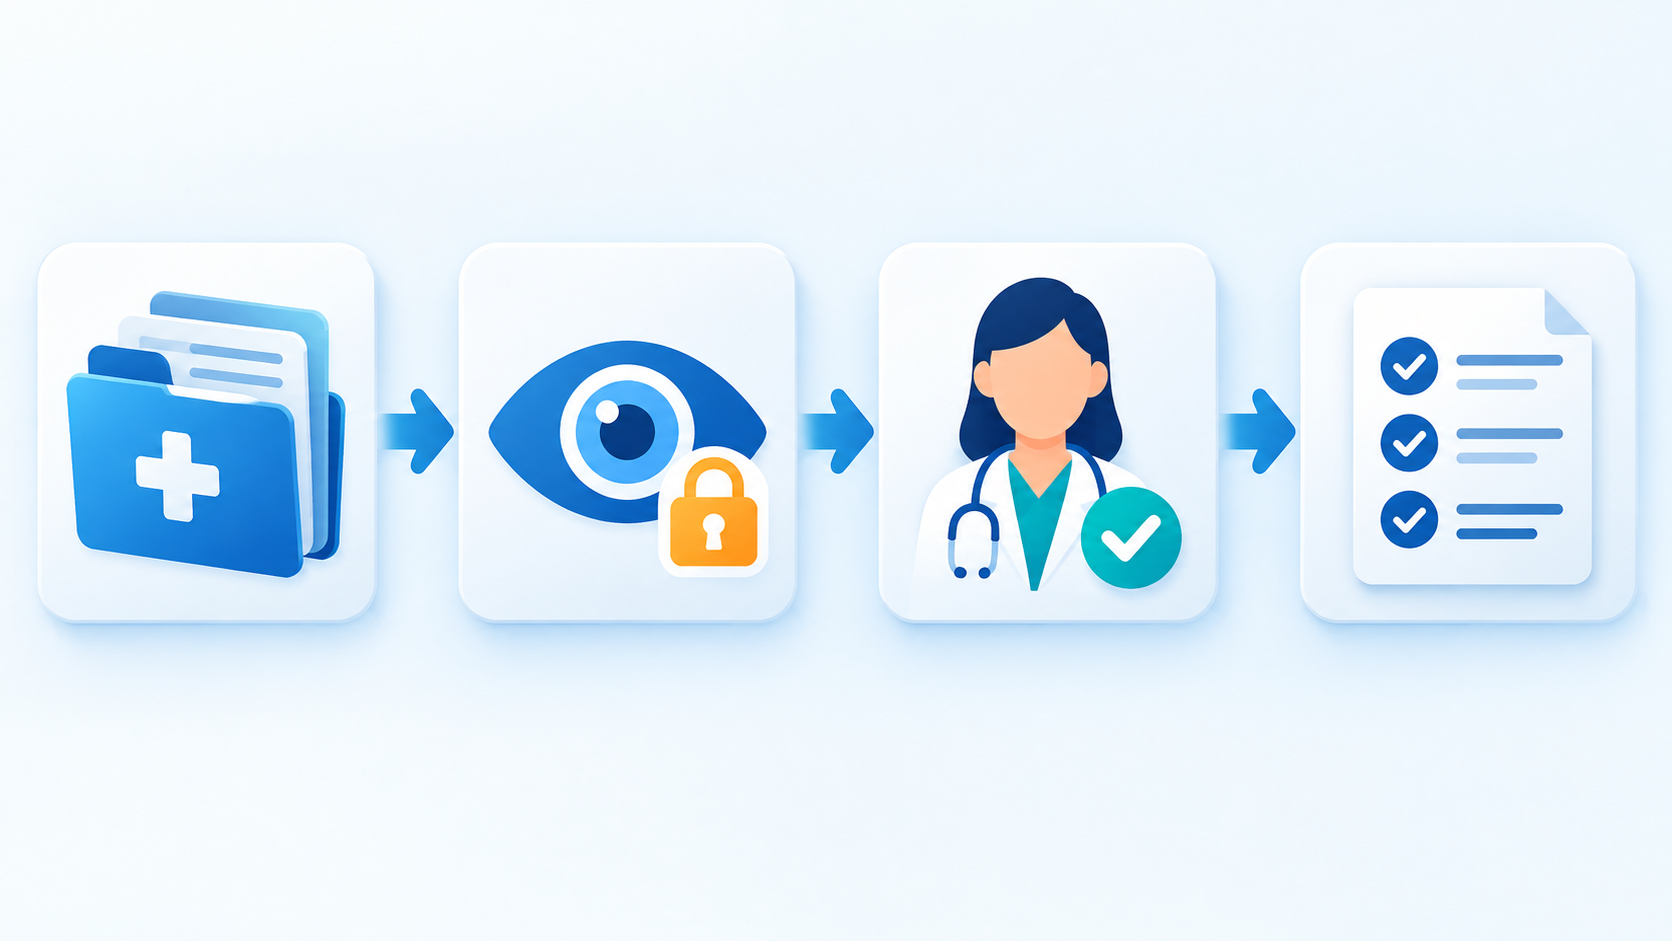
重要なのは、この接続が無条件に開かれたものではないという点です。ChatGPT側はカルテに書き戻すことができない読み取り専用のアクセスであり、対象となる患者記録は3億2,500万件規模にのぼるとされています。
あわせて、誰がどの範囲にアクセスできるかを制御する役割ベースのアクセス制御、操作の記録を残す監査ログ、そしてHIPAA(米国の医療情報保護法)に準拠した運用に必要な事業者間の取り決め(BAA)が組み合わされています。
現在では、UCSF Healthをはじめ、AdventHealth、Cedars-Sinai、HCA Healthcareなど7つの医療機関が導入パートナーとして名を連ね、接続した5つのデータソースでは、回答の9割以上が「良好」以上の精度と評価されたと報告されています。現段階ではパイロット段階であり、全医療機関への全面展開ではありませんが、医療業界のAI活用において起こった、大きな潮流と捉えることはできるでしょう。
出典・参照:
Microsoftは「モデルより先に基盤」と言い切った
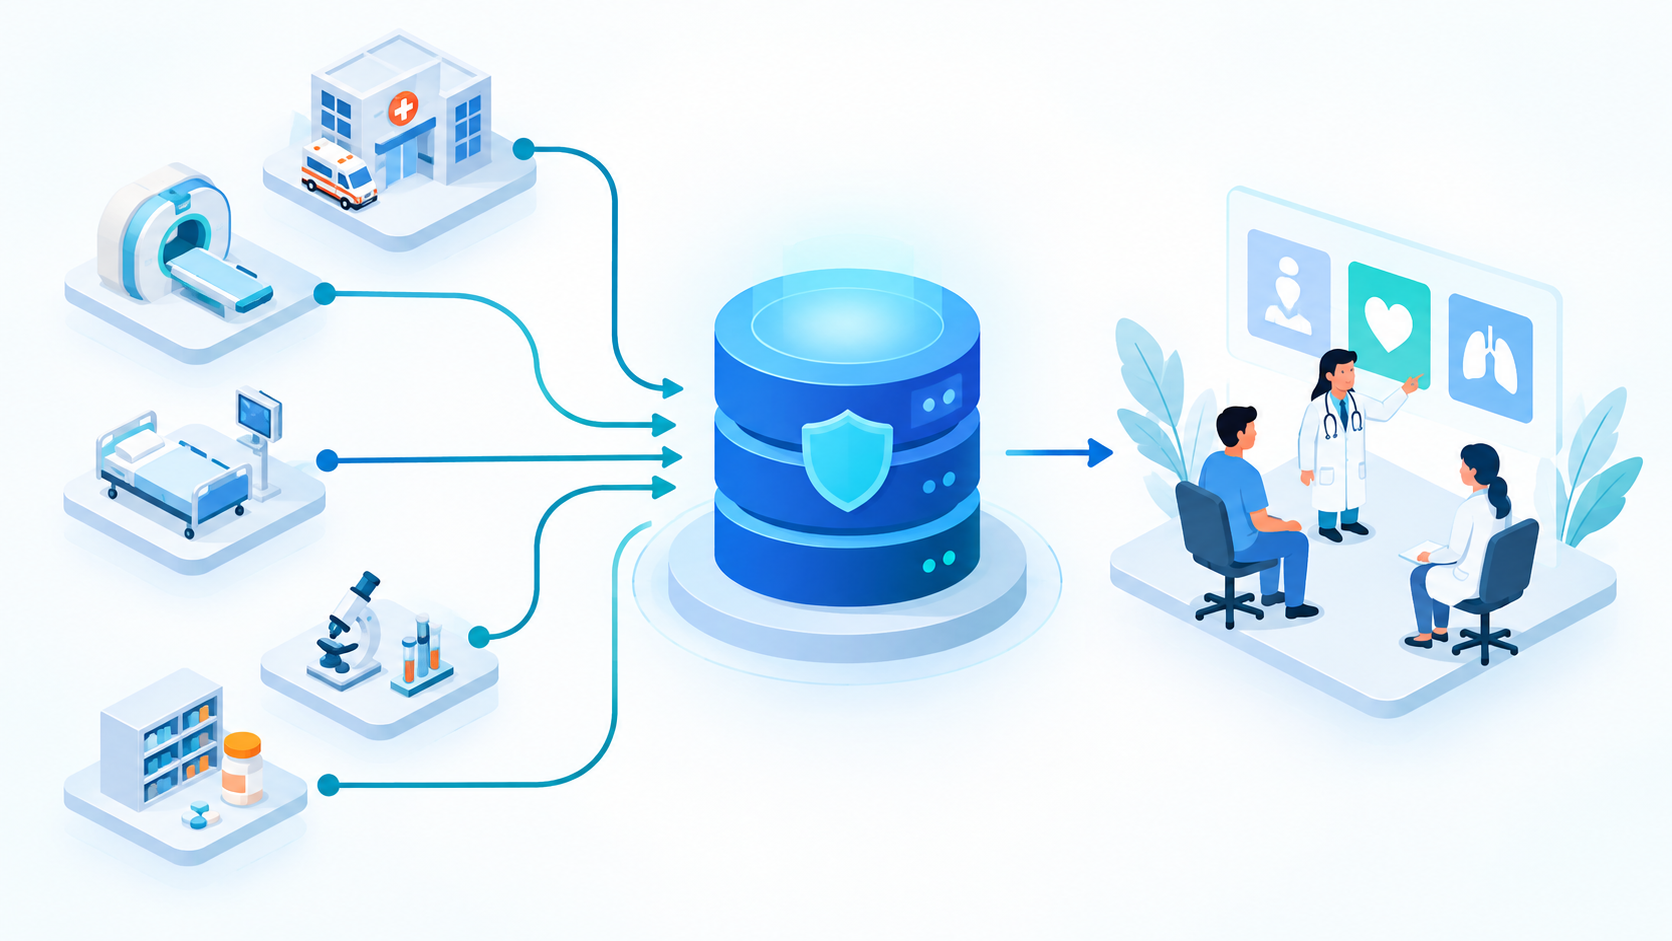
同じ2026年9月1日、Microsoftも医療AIに関するブログを公開しました。主張は明快で、AIの成否を分けるのはモデルの性能比較ではなく、部門や拠点をまたいでデータがつながり、統治された「データ基盤」があるかどうかだというものです。
Microsoftが委託しOnePoll社が実施した調査(米国・英国・ドイツ・フランス・オーストラリア・オランダ・スウェーデンの、病床数400以上の病院に勤めるAI・技術の意思決定責任者500名を対象に2026年1月に実施)によれば、ケア調整へのAIエージェント導入に前向きな医療リーダーは58%にのぼる一方、97%がデータの分断が迅速な医療提供に影響していると回答し、62%がその主因を老朽化したシステムだと答えています。意欲はあっても、それを支える基盤が追いついていないという実態がうかがえます。
出典・参照:
AI導入の判断は、モデル選びではなく接続設計
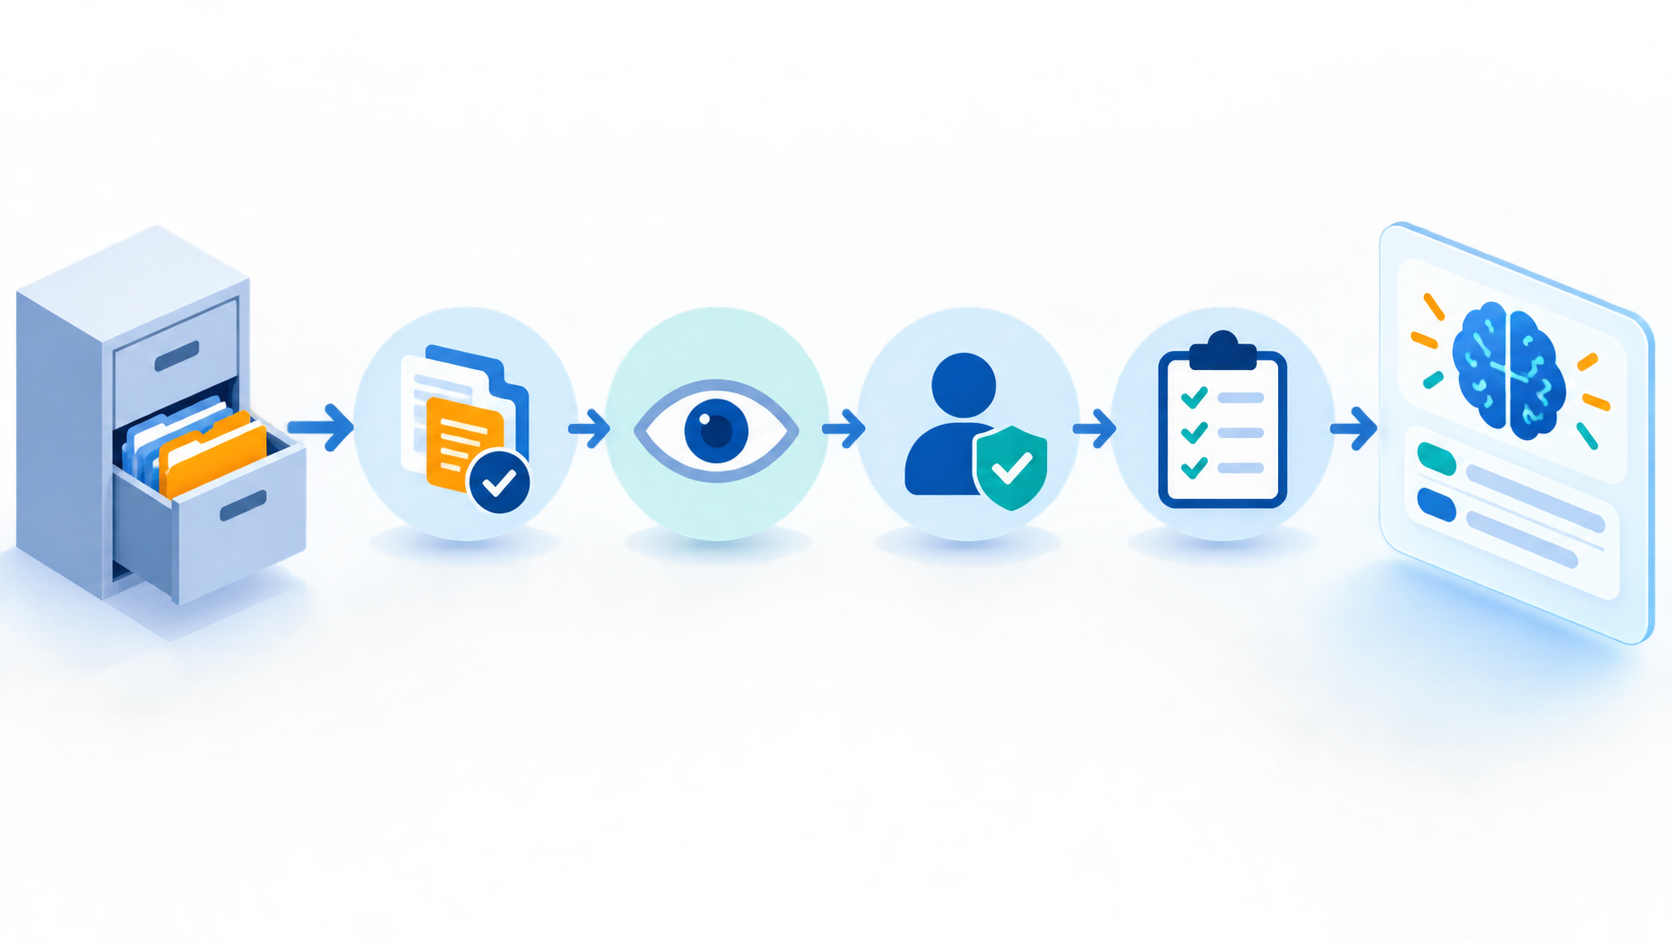
OpenAIの発表とMicrosoftの主張を重ねると、見えてくる順序は共通しています。医療という最も慎重な分野が外部AIとの接続に踏み出す際に先に固めたのは、どのモデルを使うかではなく、次のような接続の設計でした。
- どのデータを対象にするか
- 読み取りだけを許すのか、書き込みも許すのか
- 誰がアクセスできるのか
- 操作の記録をどう残すのか
これは医療業界だけの特殊な話ではありません。自社の基幹データや顧客データを外部の生成AIに接続しようとする企業であれば、業種を問わず直面する判断でしょう。
「AIを導入する」という言葉が指す中身は、モデルの性能比較ではなく、この4つの接続設計になりつつあります。医療の事例は、規制業種でさえこの順序で動いているという参照点として読むことができます。
まとめ:AI導入の判断は、モデル選びより先に接続設計から
最も慎重だったはずの医療データが、読み取り専用・認可・監査ログという設計をともなって外部の汎用AIとつながり始めました。同じタイミングで、提供側自身が「モデルより前にデータ基盤」だと明言しています。
規制の厳しい医療業界でさえこの順序で動いている以上、自社の基幹データを外部AIにどこまでつなぐかという判断は、一般の企業にとっても先送りできない現実の課題になっていると考えることができるでしょう。
- どのデータを対象にするのか
- 読み取りと書き込みのどちらを許すのか
- 誰がアクセスできるようにするのか
- 記録をどういった形で残すのか
この接続設計を先に固めることが、AI導入の出発点になります。
The post 最も慎重だった医療データが、外部AIにつながり始めた|「基盤が先、モデルは後」という順序【世界のDX潮流】 first appeared on DXportal.