


タンパク質は、化学反応を速めたり、光を放ったり、プラスチックを分解したりする、とても小さな機械です。
狙った分子の仕事をこなす専用のタンパク質を思いどおりに作ることは、分子を設計する工学の、根っこにある目標とされてきました。
ここ数年、このタンパク質をAIで一から設計する技術は、驚くほどの速さで進んでいます。
ただし、これまでのAIに「自分がほしいタンパク質」を作らせるには、ふつう、使う人の側に分子の立体の形や幾何学的な条件を指示できる専門知識が必要でした。
つまり「こういう働きをしてほしい」という願いを、多くの場合、人間が自分で設計条件に翻訳してやる必要があったのです。
ところが新しく発表されたAIは、ふだんの言葉で書いた注文文を受け取るだけで、候補となるタンパク質の配列を書き出してくるといいます。
「照らすと緑色に光るタンパク質を作って」と頼んだら、本当に光るものが出てくるのでしょうか。
研究は中国の西湖大学らにより行われ、科学雑誌で報告されました。
研究の詳細は、中国の西湖大学らにより、2026年10月21日付で学術誌『Nature』に掲載されました。
「こう働いてほしい」と書くだけのAI
今回登場したのは、「Pinal(ピナル)」と名付けられた、160億個のパラメータをもつ大規模なAIです。
使う人がすることは、ほしいタンパク質の仕事を文章で書いて入力するだけです。
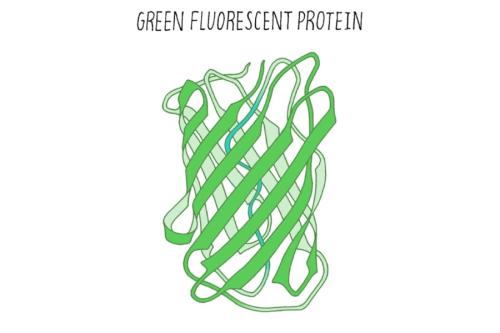
たとえば「照らすと緑色の光を出す蛍光タンパク質を設計して」といった具合です。
これまでの設計モデルには、大きく2つの縛りがありました。
一つは、多くの場合、天然のタンパク質を出発点に置いて、それを改良する形で進めるものだったこと。
もう一つは、機能の目標を、人が自分で立体の形や配列のレベルの条件に書き換えてやるのがふつうだったことです。
Pinalは、この書き換えの作業を中で肩代わりするために、2段階に分かれて働きます。
最初の部品(T2struct)が、注文の文章から立体構造の下書きを一列の記号として書き起こします。
次の部品(SaProt-T)が、その下書きと元の注文文の両方を読み、それに合うアミノ酸の並びを書き出します。
しかもPinalは、最初に思いついた形に飛びつきません。
いくつもの構造の下書きを作り、それぞれに最良の配列を設計し、組ごとに点数を付けて最終案を選ぶのです。
学習には、1億3500万本のタンパク質の配列が使われました。
研究チームは既存の注釈(データベースに書き込まれた機能の説明)とAIを使って、それぞれが何をするのかを普通の言葉で説明した文を作り、「タンパク質と文章」の対を17億組も用意しています。
立体構造のほうは、AlphaFold(タンパク質の立体構造を予測するAI)が予測した構造のデータベースから取り寄せました。
計算の上での評価では、出てきた候補は、きちんと折りたためそうな見込みが高く、注文文との合い具合もよく、しかも配列が互いに多様でした。
では、実際に作って試すと、どうなったのでしょうか。
5万本の配列から実験に進んだ29本、光ったのは何本?
研究チームはPinalに、性格の違う4つの注文を出しました。
緑に光るタンパク質、ペットボトルの素材を分解する酵素、アルコールを分解する酵素、そして代謝を手伝う「Hタンパク質」です。
結論から言えば、4つすべてで狙った働きが実験で確かめられ、2つの酵素では反応を速める力まで測れました。
ペットボトルの素材を分解する酵素では、計算のふるい分けを通った2416本のうち上位94本を試験にかけ、残ったのは1本だけでした。アルコールを分解する酵素では、2500本から選んだ系統の違う8本を試して、5本が働いています。
ただ、光るタンパク質までの道のりは、決して楽ではありませんでした。
Pinalはまず、5万本もの配列を書き出しました。
そこへ何段階もの計算によるふるい分けをかけ、実験で確かめる29本まで絞り込みます。
そして本当に光ったのは、そのうちの1本だけでした。
打率としては、かなり心もとない数字です。
それでも、この1本(pinalGFPと命名)の中身には、注目すべき点がありました。
配列を並べて比べると、pinalGFPは天然の緑色蛍光タンパク質(avGFP)とも、別の人工の変異体(esmGFP-b8)とも、大きく隔たっていたのです。
つまり、比べた2つのどちらかをなぞったものではなく、別の解答が出てきたことになります。
研究チームはpinalGFPについて、どの波長の光で励起され、どの波長の光を放つのか(蛍光の励起・発光スペクトル)まで測っています。
溶液の中での姿にも違いが出ました。
avGFPは主に2つで組になっていたのに対し、pinalGFPはもっと多くの分子が集まった形が目立つ、複雑な振る舞いを見せたのです。
一方で、細かい注文を聞かせるのは、まだ難しいようです。
研究者たち自身、蛍光タンパク質に正確な発光の波長を指定して頼むことは今も難しいままだと認めています。
ところが、残る3つのうちの1つでは、天然のタンパク質を上回る成績が出ていました。
CO2を取り込む経路で、生成物が天然の大腸菌のタンパク質を使った場合の1.7倍に
成績がぐっと上がったのは、代謝を手伝うHタンパク質でした。
ここでもまず大量に生成し、注文文との一致の良さと、すでに知られている近縁のタンパク質との配列の違い(同一性60%未満)の両方を満たす約1000本に絞っています。
そこから上位20本を実験に回したところ、5本が実際に働きました。
さらに、きちんと溶けて使える14本を、大腸菌がもともと持っている同じ役目のタンパク質と並べて比べます。
試験管の中に組み直した、アミノ酸のグリシンを作る反応系で、2時間後の生成量を測る試験です。
最もよかった「pinalH02」は、複数の酵素をつないでCO2を取り込む経路に組み込んだとき、天然の大腸菌のものを使った場合の1.7倍の生成物を出しました。
しかも、実験でくり返し手直しをする工程を、一度も経ていません。
研究チームは、計算で分子の動きを追い、pinalH02と天然のものを比べています。
Hタンパク質には、リポアミドと呼ばれる「腕」のような部分があります。
500ナノ秒ぶんの動きを追うと、天然のものではその腕が本体の近くに安定してとどまり、200ナノ秒時点の代表的な姿では、本体の内側の水をはじく空洞に収まっていました。
ところがpinalH02では、腕がしばしば外へ大きく振れ、水にさらされる位置まで出ていたのです。
もっとも、ここまで来る途中には、不格好な失敗もありました。
学習の途中の段階では、出力の60.2%に「AAAAA」のように同じアミノ酸が5つ以上続く配列が現れていたのです。
天然のタンパク質では4.0%しかない特徴です。
学習に使うデータを選び直すと、この割合は35.3%まで下がりました。
悪用への備えも取られています。
学習に使った大規模な構造のデータベースにはウイルスのタンパク質群が含まれておらず、Pinalはウイルスのタンパク質を設計するために学習させたものではありません。
また、学習データの全体と学習の手順は、全面的には公開されないことになりました。制限なく公開すると、似た仕組みを扱いの難しい生物データへ向け直す敷居を下げるおそれがあるためです。
代わりに、動かすためのコードや学習済みの重み、誰でも試せるウェブサーバーが公開されています。
これだけ進んでも、Pinalには限界があり、日常の実験道具になるまでにはまだ作業が必要だとされています。
それでも、5万本の候補から計算で選び抜いて試した29本のうち1本が実際に光り、その1本は比べた2つの緑色蛍光タンパク質とも配列が大きく違っていました。言葉による注文からタンパク質の候補を作る入口に、私たちはもう立っているようです。
参考文献
Tell this AI what you want a protein to do—and it designs one (Phys.org)
https://phys.org/news/2026-11-ai-protein.html
元論文
Programmable design of functional proteins from natural language
https://doi.org/10.1038/s41586-026-11205-z
ライター
山下 浩介: むずかしい研究を、なるべく分かりやすく伝えたい。専門の言葉はふだんの言葉に置きかえて、身近な例で例える。それで「わかった」「楽しかった」と言ってもらえたら嬉しいです。
好きなのは、通学路や台所や日常の中にある科学。眠っているあいだに記憶が整理される話や、虫の鳴き方に意味がある話のように、読み終わったあとに誰かへ話したくなる研究を探しています。
編集者
ナゾロジー 編集部
